








人工智能(AI)正加速渗透肺癌筛查、诊断、病理、治疗决策与随访管理的全流程,但"用得上"不等于"用得好",应用边界、证据来源、验证途径、公平与信任仍是全球性挑战。2026年国际肺癌研究协会(IASLC)世界肺癌大会(WCLC 2026)已于2026年9月12日—15日在韩国首尔盛大召开。ES20教育专场以"AI in Lung Cancer Care: Implementation, Equity, and Global Perspectives"为主题,邀请全球多国家专家共同探讨这一话题。IASLC人工智能工作组联合主席、孟加拉国卫生服务总局Muhammad Rafiqul Islam教授主讲中低收入国家视角的AI落地挑战,意大利米兰国家肿瘤研究所Arsela Prelaj教授系统盘点AI工具的最新进展,美国Roswell Park综合癌症中心胸外科Kenneth Patrick Seastedt教授剖析高收入环境下的AI实施挑战,KRAS Kickers患者倡导组织Chris Conneran先生则从患者视角阐释信任、透明与沟通。【肿瘤资讯】特将本场教育专场的五场报告内容进行整理,以飨读者。
IASLC AI工作组愿景:竭力构建负责任、循证、全球公平的肺癌AI未来
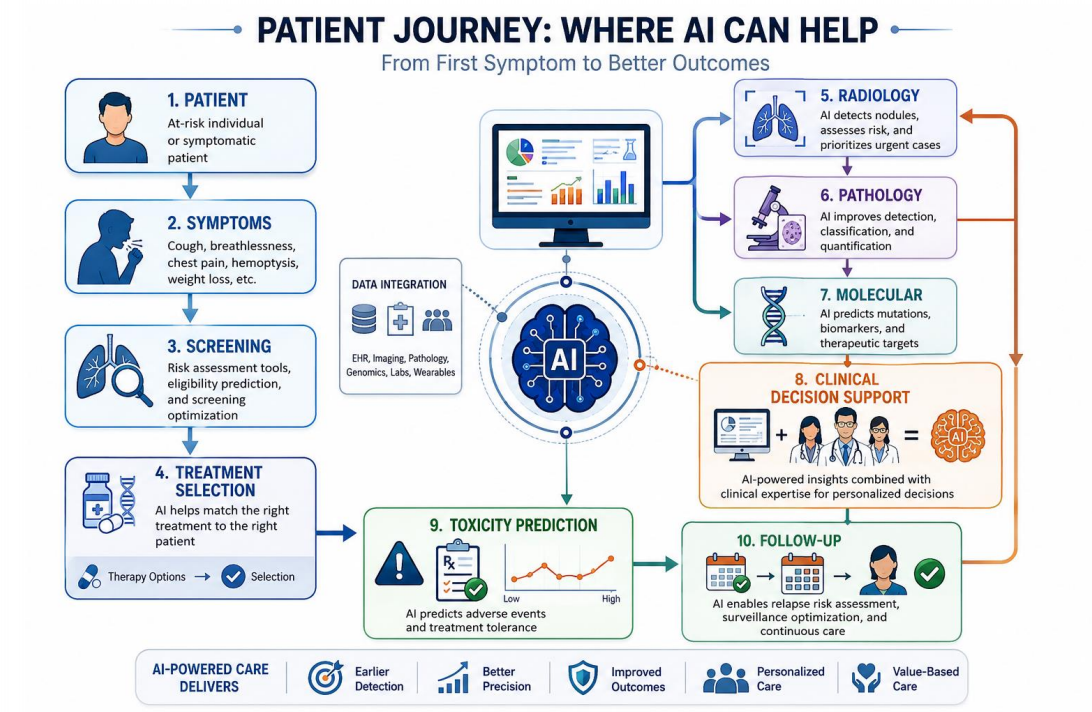
Muhammad Rafiqul Islam教授指出,AI的应用范畴已覆盖肺癌诊疗全链条——从筛查与早期检测、放射影像、病理、诊断与分期,到分子分型、治疗选择、疗效预测乃至预后与生存评估;与此同时,偏倚(Bias)、验证(Validation)、透明度(Transparency)、安全性(Safety)、信任(Trust)、监管(Regulation)与公平性(Equity)等议题也日益凸显。他特别强调,当前AI的落地速度已超过领域内共识形成的速度,这是全行业必须正视的现实。
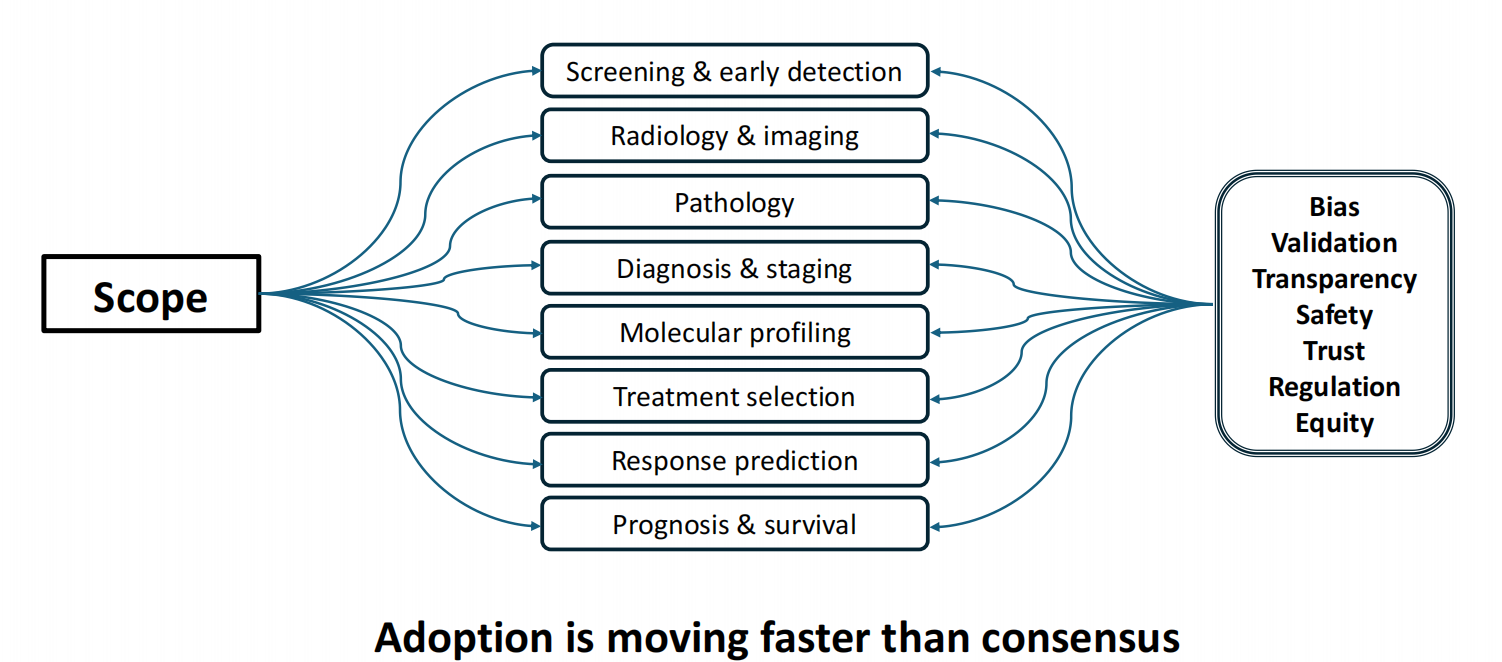
一种疾病,众多医疗体系
Islam教授指出,现有AI模型存在明显的地域集中与代表性不足问题,外部验证普遍欠缺;而不同国家和地区在基础设施、专业人才、监管环境和医疗体系方面差异巨大。"一种疾病,众多医疗体系"(One Disease but Many Health Systems)的现实,决定了AI解决方案不能简单"一刀切"。
四大愿景与首要任务
围绕"构建负责任、循证、全球适用的肺癌AI未来"这一使命,IASLC AI工作组提出四大愿景支柱:证据(Evidence)——推动AI应用的系统性评估;临床转化(Clinical Translation)——从算法走向有实质意义的临床应用;负责任AI(Responsible AI)——聚焦偏倚、公平、透明、问责与信任;全球公平(Global Equity)——确保AI在不同医疗体系中均具有相关性与可实施性。
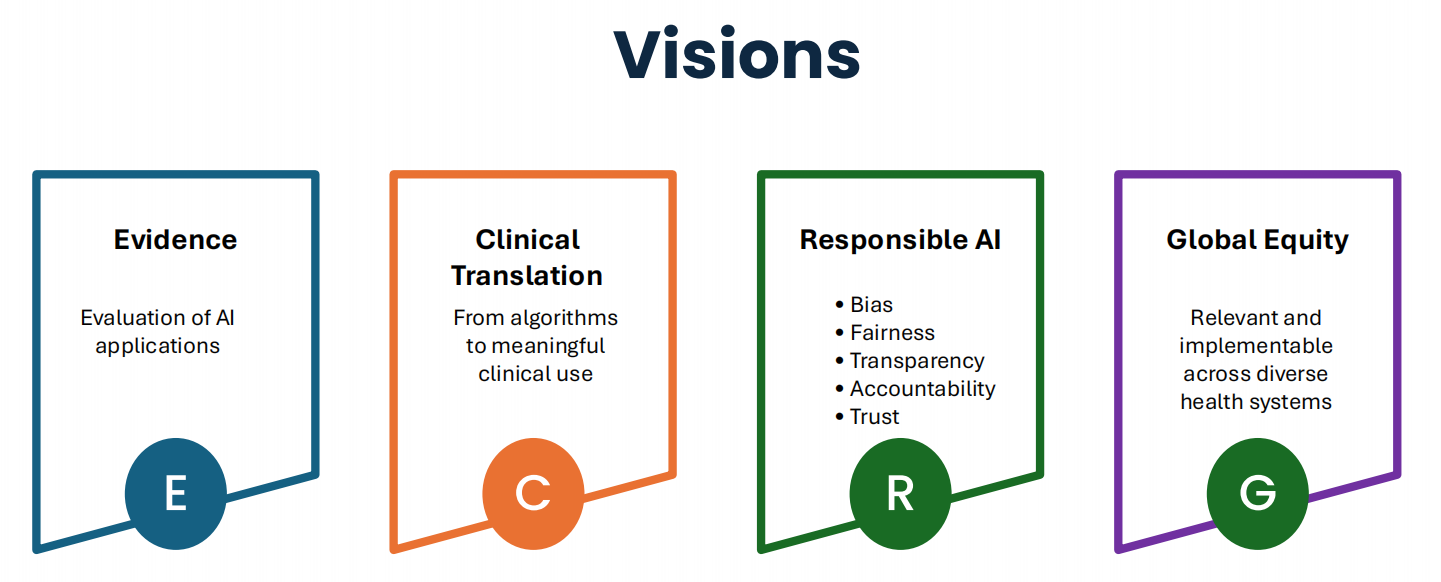
工作组的首要任务包括两方面:其一,制定IASLC肺癌负责任AI框架;其二,搭建一个共同平台,让来自世界各地的医生都能参与其中,构建适合本地需求的AI工具。IASLC AI Task Force(2025—2027)已组建全球多学科团队,并同步发起面向患者与医生的问卷调查,广泛征集一线需求。正如Islam教授所总结的工作组共同目标——"让AI准确到足以信赖、透明到足以理解、公平到足以惠及每一位患者"(AI that is accurate enough to trust, transparent enough to understand, and equitable enough to benefit every patient)。
AI在肺癌诊疗中的前沿现状:从筛查、诊断、病理到治疗决策支持
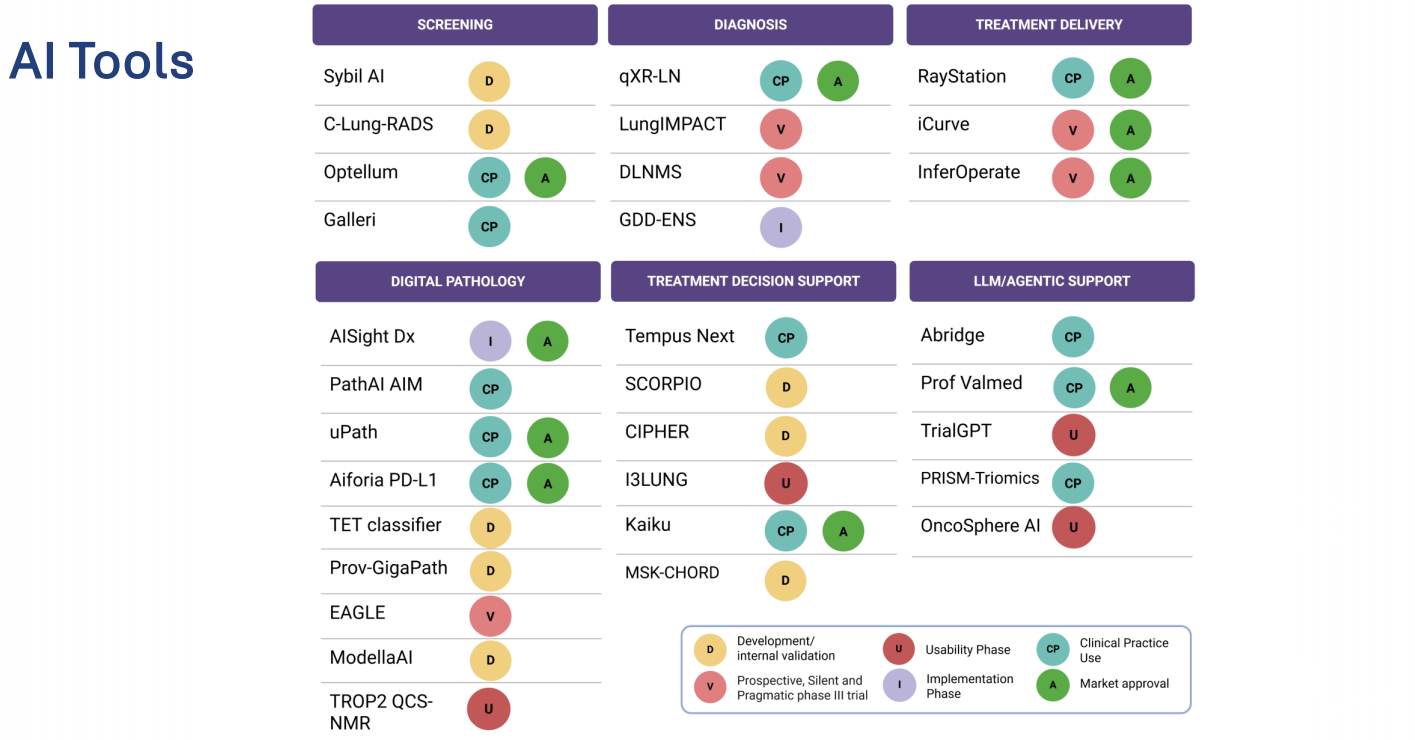
Arsela Prelaj教授首先概括了AI工具的现状:AI模型数量庞大,且开发门槛正不断降低;但真正完成临床验证并获监管批准者明显减少,而能够与工作流无缝整合、实现跨医院规模化部署者更是凤毛麟角。她强调,不同AI工具的成熟度差异巨大,识别哪些工具"已可用于临床实践"、哪些"尚待验证",是临床医生必须具备的判断力。
筛查与早期检测:预测型AI工具已趋成熟
Sybil AI(美国):基于单次低剂量CT(LDCT)预测患者未来1~6年内罹患肺癌的概率,模型基于15,000例受试者的LDCT进行训练与内部验证。在NLST测试集中,相同敏感度下Sybil将假阳性率由Lung-RADS的10%降至8%(Mikhael等,Journal of Clinical Oncology,2023)。
C-Lung-RADS(中国):将临床数据与CT影像相结合,实现个体化的LDCT监测与筛查随访。模型基于45,064例体检队列开发,并在中国西部移动CT单元14,437例受试者中独立验证;内部数据集AUC达0.918,优于单维度模型的0.881;独立数据集敏感度87.1%,阴性预测值高达99%,显著降低漏诊风险(Chengdi Wang等,Nature Medicine,2024)。
Optellum(美国/英国,FDA、CE认证):用于评估肺结节恶性风险并指导随访决策。在一项模拟AI赋能路径的研究中,指南一致性随访率由34%提升至94%,非小细胞肺癌(NSCLC)确诊中位时间由129天缩短至25天(Hill NR等,BMJ Open Respiratory Research,2025)。
影像诊断与数字病理:从辅助阅片到"从切片预测基因突变"
Qure.ai qXR-LN(美国/欧洲,FDA、CE认证):判断胸片是否含可疑肺结节。模型基于超过350万张胸片训练,经3名放射科医生独立评估的225张胸片外部验证,并在CREATE研究712例患者中完成前瞻性验证,结节检出的阳性预测值(PPV)为54.2%、阴性预测值(NPV)为93.5%——即一张"干净"的胸片可可靠地排除结节,而阳性标记中约半数可在CT中得到确认(Anchía-Alfaro等,BioMedInformatics,2026)。
AISight Dx(美国/欧洲,FDA、CE认证):泛癌种数字病理图像管理与阅片平台,验证显示数字化初始诊断非劣于光学显微镜(一致率96.6%~97.9%)。
Path AI AIM-TumorCellularity(美国/欧洲)则用于评估组织样本的肿瘤含量是否足以进行分子检测,AI预测与分子定量的相关性优于病理医师的目测估计,但目前尚无证据表明其能提高二代测序(NGS)成功率或减少假阴性(Gachechiladze等,Laboratory Investigation,2026)。
PathChat-Modella AI(美国)是获FDA突破性器械认定的多模态生成式病理辅助系统(Lu等,Nature,2024)。
EAGLE(美国/欧洲):直接基于常规苏木精-伊红(H&E)切片预测表皮生长因子受体(EGFR)突变状态,纳入多机构8,461张肺腺癌(LUAD)切片,内部验证AUC 0.847、外部验证AUC 0.870,前瞻性"静默验证"(silent validation)AUC约0.890;面向多基因预测的预印本研究也在推进中(Campanella等,Nature Medicine,2025)。
TROP2 QCS-NMR作为数字化生物标志物,可用于治疗反应预测(Garassino等,WCLC 2024,摘要PL02.11)。
治疗规划与临床决策支持:从放疗勾画到免疫治疗疗效预测
RayStation/RayPlan(放疗,CE、FDA认证):采用3D U-Net样全卷积网络进行危及器官的深度学习自动分割,通常1分钟内即可自动生成轮廓,并直接整合入治疗计划工作流,医师可审核并手动修正。
InferOperate(中国,美国,欧洲,FDA、CE、NMPA认证):面向外科的深度学习分割工具,基于500例训练,经113例回顾性与139例前瞻性患者验证,并完成140例多中心临床研究;可帮助术者识别解剖变异、优化术式选择并缩短规划时间(Chen X等,Nature Communications,2025)。
I3LUNG(免疫治疗决策支持):整合欧洲6家癌症中心2,396例III~IV期NSCLC免疫治疗患者的多模态数据(临床数据2,252例、基因组学1,723例、CT影像1,705例、H&E切片936例),构建临床决策支持系统(CDSS)。其临床可用性研究显示,可解释AI使全体医师预测真实疾病控制率(DCR)的概率提升37%、预测真实总生存期(OS)的概率提升36%,且非专家医师获益尤为显著(DCR预测:专家提升23% vs 非专家提升53%;OS预测:专家提升14% vs 非专家提升61%)。该研究成果于会议当日正式发表于Nature Medicine(Prelaj A, Miskovic V等,2026)。
生活质量监测与效率工具:生成式AI与Agentic AI走进临床
Kaiku(欧盟,CE认证):患者症状报告、分诊与医护预警工具。患者填报仅需1~4分钟,医护每周每例患者使用1~3分钟;出现预警的问卷其医护审阅中位时间为19.6小时,优于非预警问卷的21.5小时;采用率85%、依从率76%(Arriola等,The Oncologist,2024)。
Abridge(美国):将临床对话自动转化为经医师审核的文书(AI scribe)。使用者报告文书流程更简便的可能性接近7倍,在下次就诊前完成病历的可能性达5倍;至2026年中已覆盖300余家医疗系统,欧洲亦有同类工具应用(Albrecht等,JAMIA Open,2025)。
LUCC(法国):基于大语言模型(LLM)的自动数据提取工具(Aldea等,Annals of Oncology,2025)。
TrialGPT(美国):基于患者摘要在ClinicalTrials.gov中为匹配度评分并给出忠实解释,匹配准确率达87.3%、接近专家水平,可使患者招募筛选时间缩短42.6%(Jin Q等,Nature Communications,2024)。
展望未来2~3年,Prelaj教授认为,面向肿瘤多学科讨论与治疗决策的Agentic AI(智能体AI)将成为下一个发展前沿。但她也提醒,AI的可及性正加速扩张,其缔造者们却在呼吁"踩刹车",而监管规则仍在途中——三者的张力将贯穿AI临床落地的全过程。
小结
高收入环境下的AI实施挑战:证据薄弱、性能"本地化"与安全治理
Kenneth Patrick Seastedt教授开宗明义地提出警示:"我们部署AI的方式,可能是这个时代对患者安全最大的新威胁,因为我们部署这些工具的速度,已经超过了我们判断它们是否有效的速度。"
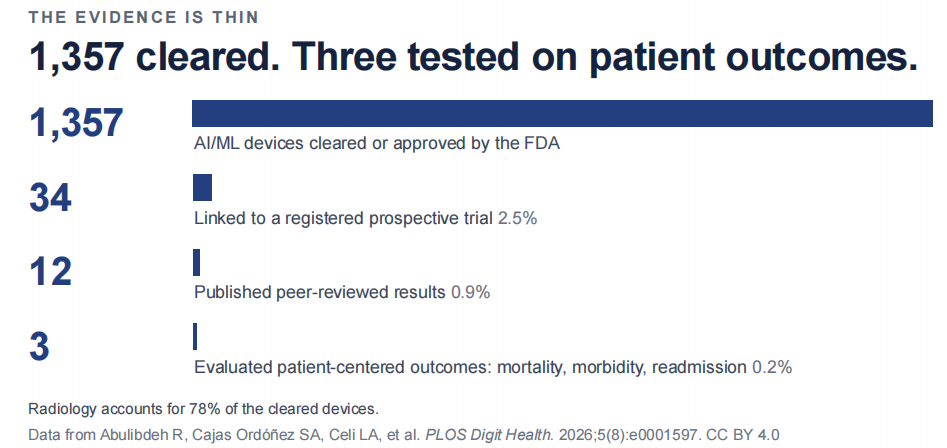
证据是薄弱的:1,357款获批器械中仅3款评估了患者结局
截至相关统计,已有1,357款AI/机器学习(ML)医疗器械获FDA批准或许可,但其中仅34款(2.5%)与注册的前瞻性试验相关联,仅12款(0.9%)发表了同行评议的结果,而真正评估以患者为中心结局(死亡率、并发症、再入院)的仅有3款(0.2%)。值得注意的是,放射领域占全部获批器械的78%(Abulibdeh R等,PLOS Digital Health,2026)。
AI为何失败:性能是"本地"的
Seastedt教授列举了三类典型教训。其一,性能随场景迁移而衰减:2021年一项纳入38,000例住院患者的研究显示,Epic脓毒症预测模型的内部验证AUC为0.76~0.83,但在外部验证中骤降至0.63,敏感度仅33%、PPV仅12%;更新后的模型才在4个医疗体系中达到0.82~0.92的AUC(Wong A等,JAMA Internal Medicine,2021)。2026年一项2,153例连续急诊头颅CT研究同样显示,商用AI的敏感度(84%)尚不及住院医师(96.4%)(Pedrini Q等,European Radiology,2026)。
其二,模型可能学到"捷径"而非疾病本身:一项经典研究发现,肺炎检测模型识别"图像来自哪家医院"的准确率超过99.9%——包括借助侧位标记等伪影——而其识别肺炎本身的AUC仅为0.75~0.80,即"认出医院比认出疾病更容易"(Zech JR等,PLoS Medicine,2018)。
其三,我们并不能可靠地发现自身的错误:据估计,美国每年与诊断错误相关的死亡或永久残疾约795,000例(可能范围598,000~1,023,000例)(Newman-Toker DE等,BMJ Quality & Safety,2024)。
上线之前:验证用例、明确责任、持续监测
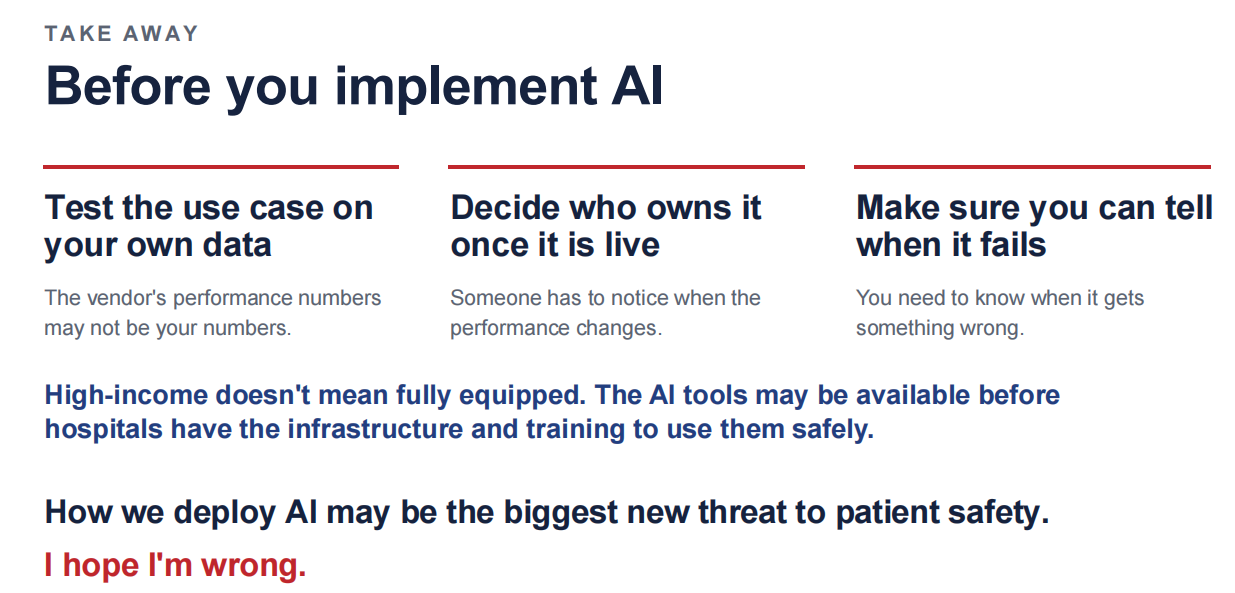
Seastedt教授提出,任何AI工具上线前必须回答两个问题:"在本地验证"(Test it here)——它在本院自己的患者身上有效吗?"指定责任人"(Name the owner)——上线之后谁负责监测?整体路径应遵循"验证(Validate)→上线(Go live)→监测(Monitor)"的闭环(Youssef A, Pencina MJ等,Nature Medicine,2023)。他强调应"验证用例,而非模型本身":以肺结节AI为例,真正的用例是"防止可干预的结节失访",因此必须明确——它应该找到谁?什么算漏诊?随访是否真的发生?"如果你无法定义它应该做什么,你就无法验证它。"
他进一步指出,"高收入"不等于"准备充分":本地验证与持续监测需要信息学能力、可靠的本地数据、生物统计学支持以及完善的治理体系。正因如此,Stanford、Mayo Clinic、Johns Hopkins、Duke、FDA、ONC、MITRE等机构均提议设立专门的"AI保障实验室"(AI assurance labs)——即使是资源高度充足的机构也承认,评估医疗AI需要专门的基础设施,而同样的商用工具所触达的医院,其评估能力却天差地别(Shah NH等,JAMA,2024)。他还倡议将AI素养列为临床胜任力,对使用AI工具的临床医生开展周期性培训,使其能够追问:"它在什么人群中验证过?它会漏掉什么?这里由谁监测?当患者特征变化时会发生什么?"
小结
最后,Seastedt教授以三句话总结实施AI前的自查清单:在你自己的数据上验证用例;明确上线后的责任人;确保你能察觉它何时失效——厂商的性能数字未必是你的数字,总要有人在性能变化时有所察觉,而你必须知道它何时犯错。
中低收入国家(LMICs)视角:为LMICs而建,而非将AI"移植"进LMICs
Muhammad Rafiqul Islam教授从疾病负担切入:LMICs目前承担了全球约70%的癌症死亡,预计到2050年这一比例将升至75%。在许多LMICs,肺癌患者的5年生存率不足10%,约80%的患者确诊时即为III~IV期;疾病谱亦与西方人群显著不同——非吸烟者占30%~40%,EGFR突变率高达35%~50%。这意味着基于西方人群训练的模型,未必适用于这些地区。
"Garbage in, garbage out":数据是第一大瓶颈
Islam教授坦言,LMICs面临严重的数据挑战:分期缺失、生物标志物缺失、病理报告不规范、ICD编码不一致、随访体系薄弱、数据集规模小——"垃圾进,垃圾出"(Garbage in, garbage out)。在许多LMICs,仅10%~20%的患者能够接受NGS检测,分子层面数据的匮乏直接制约了AI模型的开发与验证。
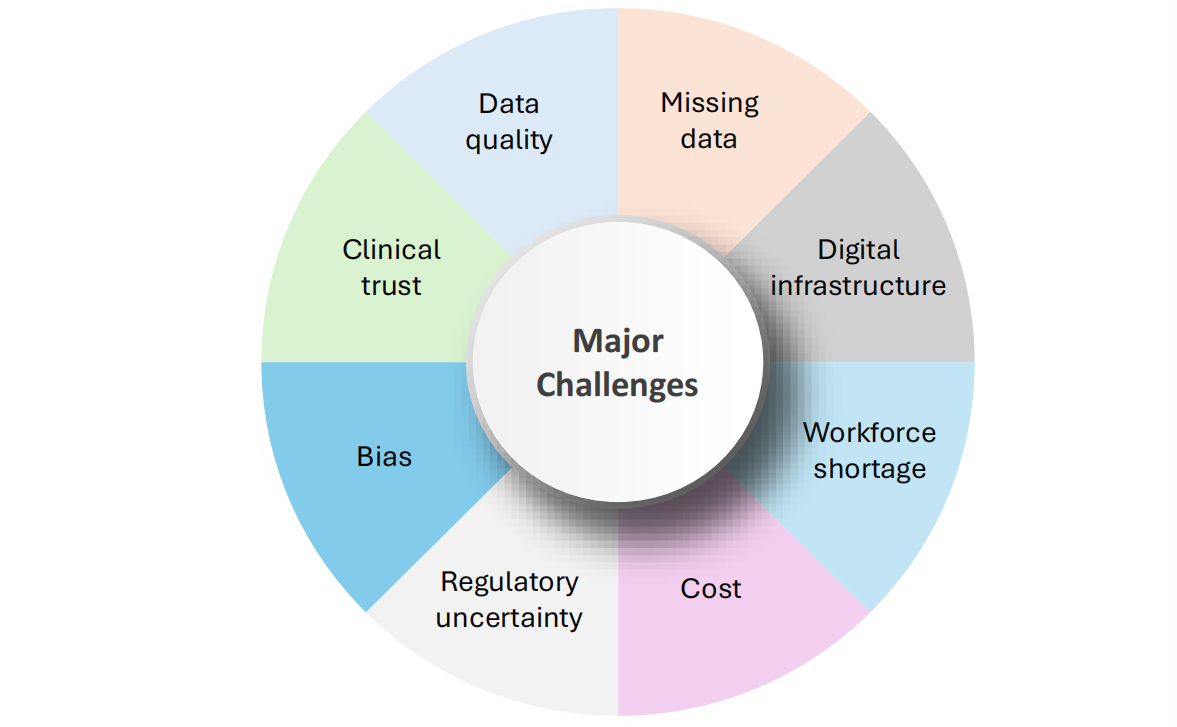
除数据质量与缺失外,落地障碍还涉及基础设施、实施与人文因素等多个层面:临床信任不足、算法偏倚、数字基础设施薄弱、专业人才短缺、监管不确定性以及成本压力。
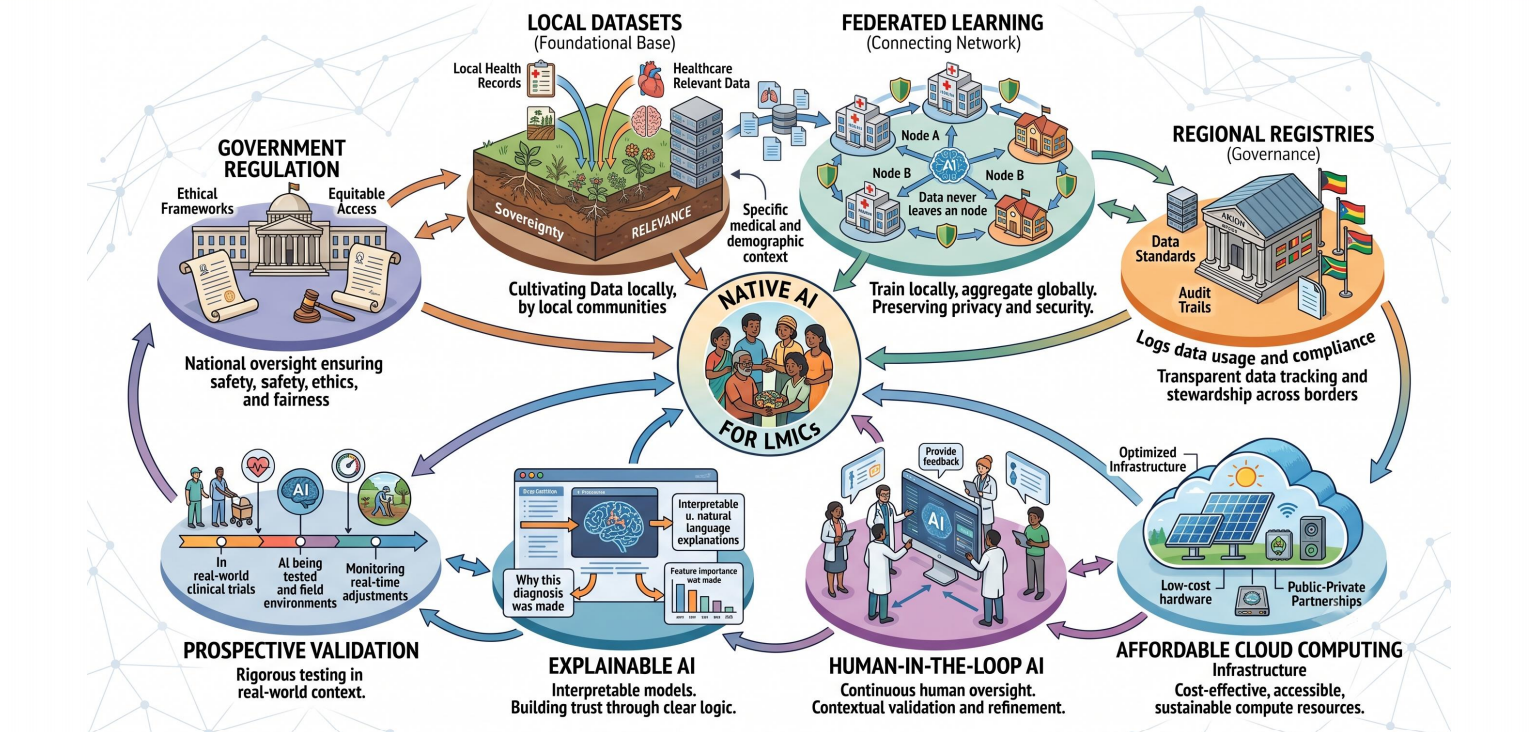
Islam教授强调,"AI的落地比算法的开发更为困难",并提出了本场报告的核心主张——"为LMICs而建造AI,而不是把AI移植进LMICs"(Build AI for LMICs—not transplant AI into LMICs)。只有立足本地的疾病谱、数据条件与医疗体系现实进行正向设计,AI才可能真正缩小而非扩大全球肺癌诊疗的差距。
患者视角:信任、透明、期望与沟通
Chris Conneran先生兼具技术领导者、照护者与患者倡导者三重身份。他指出,AI正成为"人的需求"与"医疗体系现实"之间的中介:患者渴望安全与生存、信息与选择、自主与掌控,而现实中却充斥着信息碎片化、入组标准复杂、地域可及性差异与信息过载。在这一中介位置上,信任取决于"呈现了什么、信息如何被使用、以及谁仍然保持掌控"。
警惕"眼镜蛇效应":指标不能掩盖人的需求
Conneran先生以"眼镜蛇效应"(Cobra Effect)警示AI设计中的激励扭曲:一个善意的解决方案可能产生意料之外的后果。以"帮助患者找到治疗选择"为例——究竟什么算成功?转诊量?入组数?还是患者的理解与自主?AI会围绕被定义的目标进行快速、一致、规模化的优化,而所选指标可能反过来遮蔽真实的人的需求。因此,在点击"上线"之前,必须认真定义成功的含义。
全球规范正在趋同:FAVES设计框架
全球层面的AI治理框架正走向趋同,核心要素均围绕目的、有效性、透明、隐私、人类监督、安全与监测展开:包括WHO健康AI伦理与治理框架、欧盟AI法案与欧洲健康数据空间(EHDS)、印度ICMR指南、美国ONC/FAVES框架以及亚太APACMed原则;肿瘤领域则有ASCO《肿瘤学中负责任使用AI》、ESMO AI/ELCAP项目以及IASLC AI工作组的专业引领。其中,美国卫生与公众服务部国家健康信息技术协调办公室提出的FAVES框架——公平(Fair)、适当(Appropriate)、有效(Valid)、高效(Effective)、安全(Safe)——可作为AI工具的设计标尺。
作为实践范例,Conneran先生介绍了KRAS Kickers的临床试验匹配工具:该工具基于公开的ClinicalTrials.gov数据与明确界定的纳入规则,由患者自选临床情境(癌种、KRAS变异、地域),且不限于KRAS靶向治疗;每条结果均可链接回原始注册记录;隐私设计上,检索信息仅用于本次搜索,任何后续沟通均需患者单独、主动地选择加入(opt-in);结果独立于招募、注册、申办方及任何商业目标。其最终目标并非"更多的问题",而是"准备得更好的问题"——帮助患者识别需要讨论的要点,以更充分的准备进入下一次医患对话,支持知情共享决策(informed shared decision-making)。
总结
本场ES20教育专场从学会治理、技术现状、高收入国家与LMICs的双重视角以及患者立场五个维度,全景式呈现了AI在肺癌诊疗中的机遇与挑战。在技术层面,AI工具已从单点探索走向覆盖筛查、诊断、病理、治疗规划、决策支持与随访管理的全链条,Sybil、C-Lung-RADS、EAGLE、I3LUNG等代表性成果展示了令人鼓舞的性能,生成式AI与Agentic AI正成为新的前沿。然而,多位讲者不约而同地指出:AI的部署速度已超过证据积累与共识形成的速度——获批器械中评估患者结局者寥寥无几,模型性能随场景迁移而显著衰减,"高收入"也不等于具备安全使用AI的基础设施与人才储备。在LMICs,数据质量、数字基础设施、监管与成本的多重瓶颈更决定了AI必须"为本地而建",而非简单移植。归根结底,信任、透明与患者掌控是AI落地的最终落脚点。正如IASLC AI工作组所倡导的,唯有全球同道携手共建负责任、循证且公平的AI生态,才能让AI"准确到足以信赖、透明到足以理解、公平到足以惠及每一位患者"。
排版编辑:肿瘤资讯-明小丽


 苏公网安备32059002004080号